Appliquez ce guide à votre page avec notre outil gratuit.
Testeur robots.txtRésumé de l’article
Robots.txt indique aux robots compatibles les chemins qu’ils peuvent explorer. Il ne protège pas des fichiers privés et ne constitue pas une méthode fiable de désindexation. Vérifiez le groupe du robot, la règle la plus spécifique et les URL stratégiques avant de modifier le fichier en production.
Ce que robots.txt contrôle vraiment
Un fichier public destiné aux robots compatibles
Le fichier robots.txt se place à la racine d’un hôte, par exemple à l’adresse https://exemple.ch/robots.txt. Il contient des règles qui indiquent les chemins à explorer ou à éviter. Chaque robot décide de respecter les directives qui le concernent. Le fichier doit donc être compris comme un mécanisme de gestion de l’exploration, pas comme une barrière technique contre tous les accès.
Sur un site e-commerce, certaines combinaisons de filtres peuvent produire de nombreuses URL proches. Avant de bloquer un dossier, identifiez précisément les pages utiles et celles qui multiplient les variantes sans valeur. Une exclusion trop large peut aussi empêcher le robot d’accéder à des produits, à des catégories ou à des fichiers nécessaires pour interpréter la page.
Exploration et indexation sont deux décisions distinctes
L’exploration correspond à la récupération d’une ressource. L’indexation concerne la possibilité de conserver et de présenter une page dans les résultats. Empêcher le premier mécanisme ne garantit pas l’absence de l’URL dans le second. Un moteur peut découvrir une adresse par des liens, même s’il ne peut pas charger son contenu.
Pour une page publique qui ne doit pas apparaître dans les résultats, étudiez la directive noindex documentée par Google. Le moteur doit pouvoir accéder à la réponse qui porte cette consigne. Un blocage robots.txt simultané peut justement empêcher sa lecture. Choisissez la méthode en fonction de l’objectif, pas seulement de la facilité à modifier un fichier.
La confidentialité nécessite un contrôle d’accès
Ne listez pas des documents sensibles dans robots.txt en espérant les cacher. Le fichier lui-même est public. Une personne peut lire les chemins mentionnés et essayer de les ouvrir directement. Un robot malveillant peut aussi ignorer l’ensemble des directives. Les données privées ont besoin d’une authentification et d’autorisations appliquées par le serveur.
Pour un espace client, vérifiez ce qu’une visite sans session peut réellement récupérer : documents, pièces jointes, API et liens de téléchargement. Pour un environnement de préparation, privilégiez un accès protégé. Un fichier robots.txt peut compléter une politique d’exploration, mais il ne doit jamais être le mécanisme dont dépend la confidentialité.
Le fichier de www.exemple.ch ne gouverne pas automatiquement celui d’exemple.ch ou d’un sous-domaine. Vérifiez l’hôte réellement utilisé, y compris après une migration ou un changement de domaine.
Lire et écrire des règles cohérentes
Identifier le groupe du robot
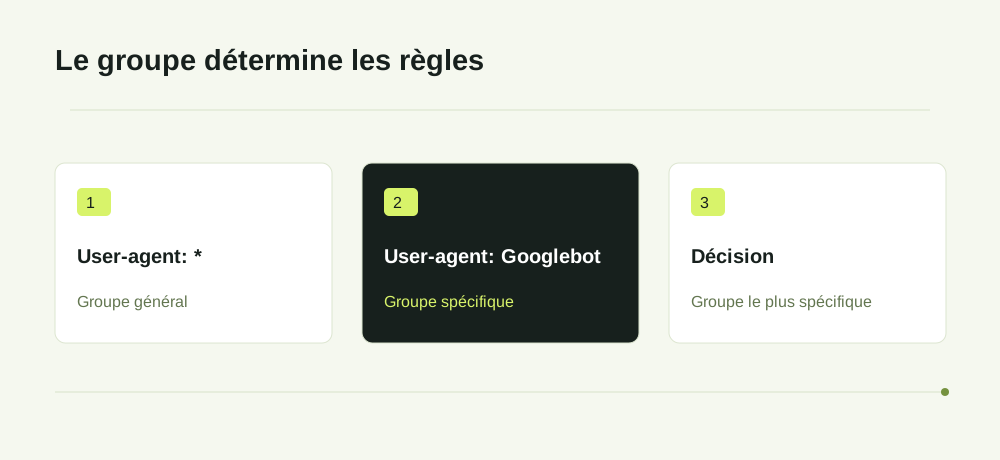
Une ligne User-agent introduit le robot visé. L’astérisque désigne un groupe général. Des groupes spécifiques peuvent s’adresser à des robots particuliers. Il faut d’abord déterminer lequel s’applique avant d’examiner les chemins. Lire seulement une ligne Disallow sortie de son groupe peut mener à une conclusion incorrecte.
Par exemple, un groupe général qui autorise l’exploration et un groupe spécifique qui interdit un dossier ne signifient pas que tous les robots recevront la même consigne. Le testeur robots.txt affiche le groupe retenu et la règle correspondante. Il devient ainsi plus simple d’expliquer le résultat et de repérer une consigne placée sous le mauvais agent.
Comprendre les chemins autorisés et interdits
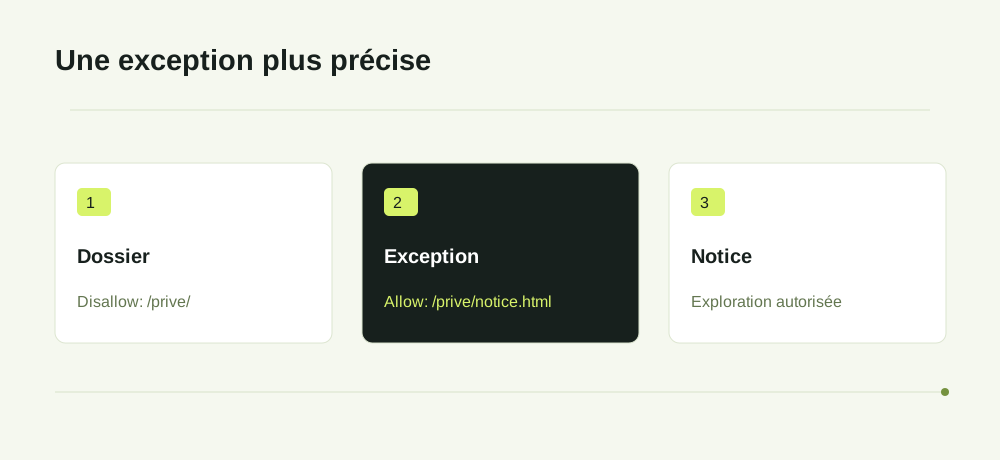
Disallow indique un chemin à ne pas explorer. Allow permet une exception. Une règle sur /prive/ concerne les URL dont le chemin commence de cette façon. Elle ne décrit pas une catégorie abstraite de contenu : elle compare des chemins. La casse, les paramètres et les caractères encodés peuvent donc avoir une importance.
User-agent: *
Disallow: /prive/
Allow: /prive/notice.html

Sitemap: https://exemple.ch/sitemap.xml
Dans cet exemple, une notice publique fait exception au dossier bloqué. Le nom du dossier ne constitue pas une protection d’accès. Si la notice doit être consultable et indexable, vérifiez également son statut HTTP, l’absence de noindex et les liens qui permettent de la découvrir. Une règle d’exploration n’annule pas les autres signaux de la page.
Départager les règles qui se recouvrent
Pour les règles compatibles avec l’interprétation de Google, la correspondance la plus spécifique prévaut. À spécificité égale, l’autorisation est retenue. L’ordre des lignes ne se lit donc pas comme une suite d’instructions où la dernière annulerait systématiquement les précédentes. Gardez les règles simples pour faciliter la vérification et la maintenance.
L’astérisque permet de représenter une suite de caractères et le signe $ la fin de l’URL dans les règles prises en charge. Une règle qui se termine par .pdf$ ne se comporte pas exactement comme une recherche de « .pdf » n’importe où dans le chemin. Un paramètre ajouté après le nom du fichier peut changer la correspondance attendue.
Écrivez votre intention en français avant la règle : « Empêcher l’exploration des résultats de recherche internes, mais conserver les catégories ». Puis construisez des exemples positifs et négatifs. Cette petite préparation réduit le risque de produire une expression très large dont les effets dépassent l’objectif initial.
Tester avant et après publication
Préparer une liste de chemins représentatifs
Ne testez pas uniquement une URL censée être bloquée. Ajoutez la page d’accueil, une catégorie importante, un produit, un article et des ressources nécessaires à l’affichage. Incluez aussi les cas limites : chemin en majuscules, paramètres de tri, pagination et éventuelles versions linguistiques. Le bon jeu d’exemples dépend de la structure réelle du site.
Dans un tableau de contrôle, associez chaque chemin au résultat attendu et à une justification. « Autorisé, car catégorie destinée à la recherche » est plus facile à relire que « OK ». Vous pouvez alors comparer le résultat du testeur à votre intention. Si l’écart vient d’un mauvais objectif plutôt que d’une erreur de syntaxe, modifier la règle ne suffira pas.
Une règle peut être syntaxiquement correcte et pourtant bloquer une page importante. Testez toujours un exemple qui doit rester accessible à côté de chaque exemple que vous souhaitez exclure.
Publier une version dont on peut revenir
Conservez le fichier précédent et notez la raison de la modification. Le générateur robots.txt peut préparer une structure simple, mais ne connaît ni vos URL ni votre serveur. Relisez donc les exclusions. Une ligne Disallow: / dans le groupe général demande de ne pas explorer l’ensemble du site.
Après le déploiement, ouvrez l’adresse exacte du fichier et vérifiez qu’elle renvoie le contenu attendu, sans page de connexion ni message d’erreur à la place. Contrôlez également les éventuels caches et redirections. Le test du texte copié ne peut pas prouver que le serveur diffuse la bonne version. Ce second niveau de contrôle est indispensable.
Observer le comportement sans surinterpréter
Les robots ne reprennent pas tous immédiatement une nouvelle version. Une modification de fichier ne prouve pas non plus qu’une page sera explorée à la prochaine visite. Examinez les outils du moteur et, lorsque vous y avez accès, les journaux du serveur. Cherchez des éléments concordants plutôt qu’une seule observation isolée.
Si des pages utiles cessent d’être accessibles, revenez au fichier conservé puis recherchez la règle en cause. Si des pages indésirables restent indexées, reprenez la distinction entre exploration et indexation. Ne multipliez pas les exclusions sans diagnostic : le problème peut venir de liens internes, de paramètres, de signaux canoniques ou d’un objectif de désindexation mal traduit.
Une maintenance durable consiste à garder peu de règles, chacune compréhensible et testable. Réexaminez le fichier après une refonte, l’ajout d’une langue ou un changement de structure. Les anciens chemins peuvent devenir inutiles, et les nouveaux peuvent nécessiter une décision différente. Le fichier doit suivre le site réel, pas accumuler son historique technique.
Questions fréquentes
Disallow supprime-t-il une page de Google ?
Non. Une URL bloquée peut encore apparaître si Google la connaît par des liens. Pour une page accessible à tous qui ne doit pas être indexée, utilisez une directive noindex lisible par le robot.
Faut-il ajouter Allow: / ?
L’exploration est autorisée par défaut lorsqu’aucune règle applicable ne l’interdit. Un Allow général est donc souvent inutile. Une autorisation spécifique peut en revanche créer une exception à un blocage.
Les majuscules changent-elles une règle ?
Les chemins sont sensibles à la casse : /Prive/ et /prive/ ne sont pas identiques. Les noms des directives ne le sont pas. Testez les chemins sous la forme réellement utilisée par votre site.
Un sitemap dans robots.txt force-t-il l’indexation ?
Non. Il indique où trouver une liste d’URL. Les pages restent soumises à l’exploration, à la sélection canonique et aux décisions d’indexation du moteur.
Le testeur télécharge-t-il mon fichier ?
Oui. Vous indiquez l’URL de la page et le fichier robots.txt du domaine est récupéré automatiquement. Le test compare ensuite les règles au chemin. Le cache réel de Google et l’indexation restent à contrôler séparément.
Puis-je cacher des documents confidentiels avec robots.txt ?
Non. Le fichier est public et ses règles reposent sur le respect du robot. Protégez les documents avec une authentification et des contrôles d’accès au serveur.
Sources

Média et plateforme de ressources consacrés au référencement naturel. Des guides pratiques accompagnés d’outils gratuits.