Contrôlez les principaux signaux techniques d’une URL.
Audit SEO gratuitRésumé de l’article
Le SEO technique s’occupe des conditions qui permettent aux moteurs de découvrir, charger, comprendre et indexer les bonnes URLs. Son rôle n’est pas de “faire ranker” une page à lui seul : il évite que l’infrastructure, le HTML ou les règles d’exploration sabotent un contenu qui mérite d’être visible.
Le SEO technique commence avant les mots-clés
Une page peut être parfaitement rédigée et pourtant rester invisible si le serveur renvoie une erreur, si Googlebot est bloqué, si une directive noindex est active ou si une autre URL est considérée comme canonique. Le SEO technique consiste à identifier ces contraintes et à construire un environnement où les pages importantes sont faciles à découvrir et à interpréter.
Google résume ses exigences minimales de manière surprenante : Googlebot ne doit pas être bloqué, la page doit fonctionner avec une réponse HTTP réussie et contenir du contenu indexable. Tout le reste sert ensuite à clarifier, prioriser et maintenir le site. Cela ne rend pas les autres aspects du SEO secondaires ; cela rappelle simplement qu’une base cassée peut annuler beaucoup d’efforts éditoriaux.
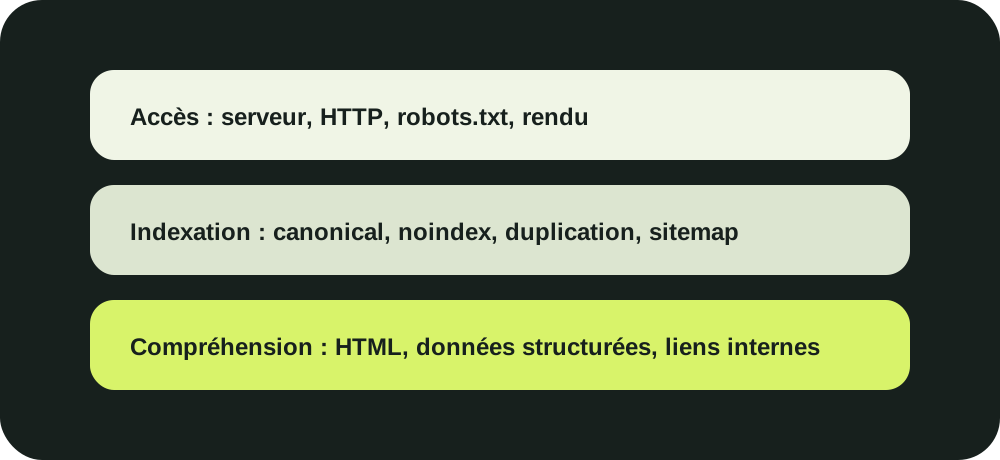
Le contrôle SEO par URL permet de vérifier plusieurs de ces éléments sur une page publique. Il ne remplace pas un crawl complet, mais il aide à distinguer rapidement un problème de réponse HTTP, de directives, de balises ou de structure.
Exploration : rendre les bonnes URLs accessibles
Statuts HTTP et redirections
Un statut 200 indique qu’une page a été servie avec succès. Une redirection 301 ou 308 indique qu’une ressource a changé d’adresse de manière permanente. Les erreurs 404 ou 410 signalent qu’une ressource n’est plus disponible. Le problème ne vient pas de l’existence d’une 404 en soi : il apparaît lorsque des liens importants mènent vers elle, lorsque des URLs supprimées devraient être redirigées ou lorsqu’un serveur renvoie à tort un faux 200 pour une page absente.
Gardez les chaînes de redirections courtes. Chaque saut ajoute une étape et complique le diagnostic. Notre testeur de redirection permet de suivre une URL et de voir les réponses successives.
Robots.txt : gérer l’exploration, pas la confidentialité
Le fichier robots.txt donne des instructions aux robots compatibles sur les chemins qu’ils peuvent explorer. Il ne constitue ni un contrôle d’accès ni une garantie de désindexation. Le guide robots.txt détaille les groupes, Allow, Disallow et les pièges courants.
Une erreur classique consiste à bloquer une URL dans robots.txt puis à attendre que Google lise sa balise noindex. Si le robot ne peut plus récupérer la page, il ne peut justement pas lire la directive HTML. Choisissez la règle selon l’objectif : limiter le crawl, éviter l’indexation, protéger un contenu privé ou supprimer une ancienne URL sont quatre besoins différents.
Indexation : aider le moteur à choisir la bonne version
Canonical et doublons
Plusieurs URLs peuvent afficher un contenu très proche : paramètres, variantes de tri, versions HTTP/HTTPS, pages imprimables ou duplications créées par un CMS. La balise canonical indique l’URL que vous considérez comme représentative, mais Google la traite comme un signal et peut choisir une autre version si les autres éléments du site racontent une histoire différente.
Une canonical cohérente s’accompagne généralement de liens internes vers la bonne URL, d’un sitemap qui référence cette version et de redirections lorsque les variantes n’ont aucune raison de rester accessibles.
Sitemaps XML
Un sitemap aide les moteurs à découvrir les URLs que vous souhaitez leur signaler. Il ne garantit ni le crawl ni l’indexation. Utilisez-le surtout comme inventaire propre des pages canoniques et indexables. Les URLs en erreur, redirigées ou volontairement noindex n’ont généralement rien à y faire.
Vous pouvez tester un sitemap XML ou en générer un simple avec notre générateur de sitemap. Sur un CMS, vérifiez d’abord ce qui est déjà produit automatiquement avant d’ajouter un deuxième mécanisme.
Directives d’indexation
noindex demande à Google de ne pas conserver la page dans ses résultats. Les directives peuvent être placées dans une balise meta robots ou dans un en-tête HTTP. Avant de corriger “une page non indexée”, vérifiez donc si l’exclusion est volontaire : pages de remerciement, résultats de recherche internes ou environnements privés n’ont pas forcément vocation à apparaître.
HTML, JavaScript et compréhension du contenu
Google peut rendre du JavaScript, mais cela ne signifie pas que toutes les implémentations sont équivalentes. Une navigation importante construite uniquement après une interaction complexe, du contenu chargé depuis une API instable ou des URLs qui n’existent qu’à l’intérieur d’un état JavaScript peuvent rendre la découverte et le diagnostic plus difficiles.
Pour les contenus importants, privilégiez des URLs stables et des liens HTML crawlables. Vérifiez le HTML initial et le document rendu lorsque votre framework ajoute une partie du contenu côté client. Si un outil d’analyse par URL ne voit pas un élément qui apparaît pourtant dans votre navigateur, cette différence est justement une information à examiner.
Données structurées : préciser le sens, sans inventer
Les données structurées peuvent aider Google à comprendre des entités et rendre certains contenus éligibles à des fonctionnalités spécifiques. Elles ne garantissent pas un résultat enrichi. Le balisage doit correspondre au contenu visible et respecter les propriétés attendues pour le type choisi.
Testez la syntaxe et la cohérence, mais ne transformez pas Schema.org en exercice de remplissage. Ajouter dix types inutiles n’améliore pas automatiquement la page.
Performance, mobile et expérience : où les placer dans l’audit
La performance technique mérite d’être mesurée, mais elle ne doit pas devenir un score abstrait qui écrase toutes les autres priorités. Une page lente peut frustrer les visiteurs et compliquer certains usages ; une page rapide mais vide de contenu utile ne devient pas pour autant une bonne réponse. Le diagnostic doit relier les métriques à l’expérience réelle et au type de page.
Mesurez ce que vit l’utilisateur
Les Core Web Vitals décrivent notamment la vitesse d’affichage du contenu principal, la réactivité et la stabilité visuelle. Utilisez des données de terrain quand elles sont disponibles, complétées par des tests de laboratoire pour reproduire les problèmes. Un pic ponctuel dans un outil n’est pas toujours représentatif de la majorité des visites.
Vérifiez aussi les bases : page lisible sur mobile, boutons accessibles, texte qui ne déborde pas, images correctement dimensionnées et absence de décalages majeurs pendant le chargement. Google utilise aujourd’hui un crawler mobile par défaut ; tester uniquement un grand écran de bureau n’est donc pas une validation suffisante.
Ne confondez pas performance et crawl
Un site très lent ou instable peut compliquer l’exploration, mais “améliorer le score PageSpeed” n’est pas une stratégie de crawl à lui seul. Sur les sites importants, observez aussi les réponses serveur, les erreurs 5xx, les temps de réponse, la quantité d’URLs inutiles et la façon dont les robots circulent dans l’architecture. Sur un petit site de quelques dizaines de pages, la priorité est souvent beaucoup plus simple : éviter les erreurs, garder des pages accessibles et une navigation claire.
Une méthode d’audit qui évite la checklist infinie
Étape 1 : déterminer le périmètre
Un audit d’une page, d’un template et d’un site entier ne répond pas aux mêmes questions. Commencez par les URLs qui ont une valeur commerciale ou éditoriale réelle. Sur un petit site, vous pouvez souvent cartographier toutes les pages importantes. Sur un grand site, travaillez par modèles et segments.
Étape 2 : chercher les blocages avant les optimisations
Vérifiez l’accès, les statuts HTTP, robots.txt, noindex, canonical et redirections avant de discuter de micro-optimisations. Un titre imparfait est rarement prioritaire devant une page qui redirige vers la mauvaise destination ou un template entier exclu de l’index.
Étape 3 : relier chaque anomalie à une conséquence
“Il y a 37 H2” n’est pas une conclusion. Demandez ce que cela empêche réellement : la structure est-elle illisible, les sections sont-elles mal hiérarchisées, ou la page est-elle simplement longue ? Classez les problèmes selon leur impact, leur étendue et le coût de correction.
Une anomalie répétée sur 5 000 URLs peut être plus importante qu’un problème spectaculaire sur une page secondaire. Mesurez toujours l’échelle avant de choisir l’ordre des corrections.
Étape 4 : contrôler après déploiement
Une correction n’existe réellement qu’une fois publiée. Retestez la réponse du serveur, le HTML, les redirections et les directives. Puis surveillez Search Console et, lorsque c’est utile, les logs. Le SEO technique est autant une discipline de validation qu’une discipline de configuration.
Quels contrôles automatiser et lesquels garder humains ?
Automatisez ce qui est répétitif et observable : statut HTTP, présence d’un Title, longueur indicative d’une description, canonical, directives, liens cassés, redirections, sitemap ou structure Hn. Gardez une relecture humaine pour ce qui exige du contexte : une canonical est-elle voulue ? le H1 décrit-il réellement la page ? un lien externe est-il utile ? une catégorie mérite-t-elle d’être indexée ?
Cette distinction est importante parce qu’un audit technique génère facilement une longue liste de “problèmes” qui sont parfois de simples caractéristiques du site. Un bon rapport ne se contente pas de compter : il aide à décider ce qui doit être corrigé maintenant, plus tard, ou pas du tout.
Si vous débutez, ne cherchez pas à maîtriser tous les sujets en même temps. Le parcours pour apprendre le SEO vous aide à relier technique, contenu, architecture et mesure sans transformer le référencement en collection de checklists.
Questions fréquentes
Le SEO technique suffit-il pour bien se positionner ?
Non. Il crée de bonnes conditions d’exploration et d’indexation, mais le contenu, l’intention, les liens et la concurrence restent déterminants.
Faut-il un sitemap XML sur tous les sites ?
Il est particulièrement utile pour aider les moteurs à découvrir les URLs, surtout sur les sites importants ou complexes. Un petit site très bien maillé peut être découvert sans sitemap, mais en fournir un propre reste pratique.
Une erreur 404 est-elle toujours mauvaise pour le SEO ?
Non. Une 404 est normale pour une ressource réellement supprimée sans équivalent. Le problème apparaît surtout lorsque des pages importantes ou de nombreux liens internes pointent par erreur vers des URLs absentes.
Quelle est la première chose à vérifier dans un audit technique ?
Commencez par l’accès aux pages importantes : statut HTTP, robots.txt, noindex et canonical. Les optimisations secondaires n’ont aucun intérêt si la page n’est pas correctement accessible ou indexable.
Sources

Média et plateforme de ressources consacrés au référencement naturel. Des guides pratiques accompagnés d’outils gratuits.